Jev statt ChatGPT: 100-mal billiger, und meine Antwortquote war geschönt
Jev ist ein neues KI-Modell, das nicht schreibt, es entscheidet nur. Ich habe es an 193 echten Antworten aus meinen Kampagnen getestet: 0,8 Sekunden je Antwort, 0,6 Cent für alle zusammen, rund hundertmal billiger als ein Chatmodell. Nebenbei kam heraus, dass jede zehnte als positiv geführte Antwort keine war.
- 0,6 Cent
- Kosten für alle 193 Einordnungen mit JevSelbst gemessen, 0,8 Sekunden je Antwort
- 1 von 10
- Als positiv geführte Antworten war keineUrlaubsnotizen, eine Werbemail, eine klare Absage
- 91 %
- Anteil, den eine Maschine sicher einordnetDer Rest geht zur Prüfung an einen Menschen
Eigene Auszählung aus dem Postfach von FL Digital, geprüft am 19. und 20. September 2026. Ein Postfach, eine Zielgruppe. Methode und Grenzen im letzten Abschnitt. Listenpreise laut TypeSafe AI, Stand 15. September 2026.
Die kurze Antwort
- Das Modell heißt Jev, kommt von TypeSafe AI und ist seit dem 15. September 2026 in einer frühen Testphase zugänglich. Es schreibt keinen Text. Es wählt aus Antworten, die du vorgibst, und nennt dazu seine Sicherheit.
- Jede zehnte als positiv geführte Antwort war keine. Darunter Urlaubsnotizen, eine Werbemail eines Software-Anbieters und eine klare Absage.
- In den Streitfällen lag die Maschine öfter richtig als das Etikett aus dem Versandtool: von 21 Abweichungen gingen rund 12 auf ein falsches Etikett zurück.
- Bessere Fragen haben die Trefferquote nicht gehoben. Vier Fassungen, dasselbe Ergebnis. Die Grenze liegt in der Datenqualität.
- Der praktische Gewinn ist die Sortierung: 91 von 100 Antworten werden sicher eingeordnet, 9 landen zur Prüfung auf dem Tisch.
- Credits sparst du vor allem durch Arbeitsteilung: Einsortieren an Jev, Schreiben an ein Chatmodell, alle Fragen in einen Aufruf und nur den Antworttext senden, nie den ganzen Verlauf.
Woher die Zahl kommt, mit der du dein Quartal bewertest
In einem typischen Aufbau laufen Kaltakquise-Mails über ein Versandtool. Antwortet jemand, bekommt die Antwort dort einen Status: interessiert, kein Interesse, abwesend, falscher Ansprechpartner. Gesetzt wird er teils von Hand, teils automatisch.
Aus diesen Status entsteht später der Bericht: so viele Kontakte angeschrieben, so viele positive Antworten, daraus die Quote. Diese eine Zahl entscheidet, ob eine Kampagne weiterläuft, ob die Ansprache taugt und ob das Geld richtig liegt.
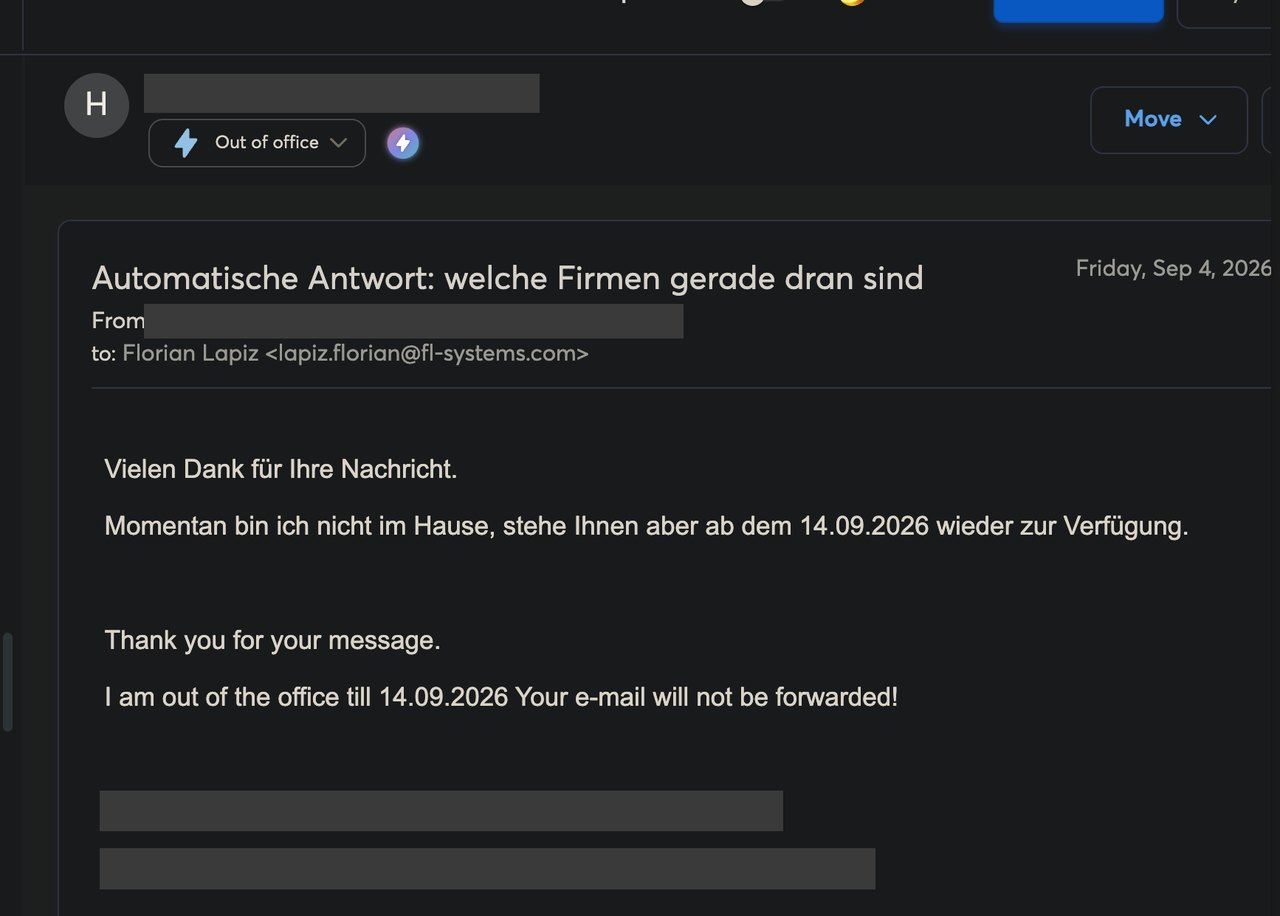
Der Haken: Eine Urlaubsnotiz sieht für eine automatische Einordnung freundlich aus. Sie enthält Dank, einen vollständigen Satz und oft einen Namen. Sie sagt aber nichts über Interesse. Landet sie im Topf für positive Antworten, steigt deine Quote, ohne dass ein einziges Gespräch näher gerückt wäre.
Der Test: 193 echte Antworten
In meinem Versandtool liegen 1.683 Antworten, fast alle mit Status. Daraus habe ich 193 gezogen, absichtlich gemischt: 60 Abwesenheitsnotizen, 60 Absagen, 50 positive und 23 mit Verweis auf eine andere Person.
Jede Antwort ging an Jev, ein Entscheidungsmodell von TypeSafe AI, das keinen Text schreibt und ausschließlich einordnet. Zu jedem Urteil liefert es eine Sicherheit zwischen 0 und 1. Dauer je Antwort rund 0,8 Sekunden, Kosten für alle 193 zusammen sechs Zehntel Cent.
Dann habe ich jede Abweichung einzeln gelesen und entschieden, wer recht hatte: das Etikett aus dem Versandtool oder die Maschine.
| Kennzahl | Wert |
|---|---|
| Übereinstimmung mit dem Etikett aus dem Versandtool | 89 % |
| Abweichungen insgesamt | 21 Fälle |
| davon: Etikett war falsch | rund 12 |
| davon: Fall wirklich doppeldeutig | rund 8 |
| davon: Maschine lag falsch | 1, mit Sicherheit 0,41 |
| Dauer je Antwort | 0,8 Sekunden |
 Vollansicht
Welches Modell das ist: Jev von TypeSafe AI
Das Modell heißt Jev. Gebaut hat es TypeSafe AI, ein junges Unternehmen von der US-Westküste. Gründer Diogo Almeida war vorher bei OpenAI und hat dort an den Methoden mitgearbeitet, aus denen ChatGPT entstanden ist. Jev ist am 15. September 2026 erschienen, als erstes öffentliches Modell einer neuen Klasse, die TypeSafe System One Models nennt.
Die Namen sind Programm. System One steht für das schnelle, intuitive Denken aus Daniel Kahnemans Buch Schnelles Denken, langsames Denken. Jev ist nach William Stanley Jevons benannt, dem Ökonomen, der beobachtet hat, dass sparsamere Dampfmaschinen den Kohleverbrauch erhöht haben. Die Wette dahinter: Wird Intelligenz hundertmal billiger, findet sie hundertmal mehr Einsatzorte.
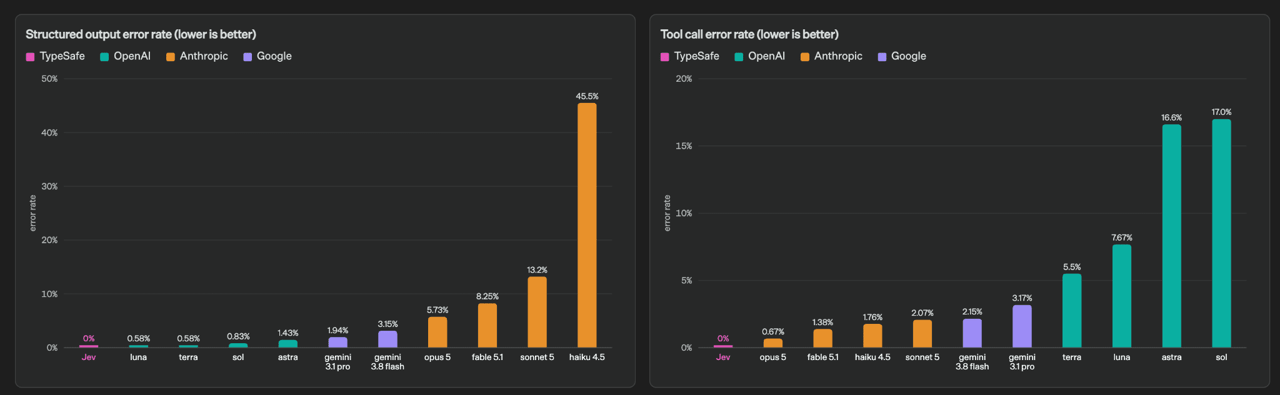
Der technische Kern in zwei Sätzen: Jev gibt keinen Text aus. Du legst vorher fest, welche Antworten erlaubt sind, und Jev liefert für jede eine Wahrscheinlichkeit, alle gleichzeitig statt Wort für Wort. Deshalb kann es sich keine Kategorie ausdenken, und deshalb ist es so schnell und so billig.
Zur Einordnung: Tempo und Kosten in diesem Artikel habe ich selbst gemessen, aus Deutschland, an meinen eigenen Daten. Die Vergleiche mit anderen Modellen stammen vom Hersteller. Die Originalquelle ist am Ende des Artikels verlinkt.
 Vollansicht
{
  "kategorie": "abwesenheit",
  "sicherheit": 0.99,
  "verteilung": {
    "abwesenheit": 0.99,
    "absage": 0.01,
    "positiv": 0.00,
    "falscher_ansprechpartner": 0.00
  }
}Was in den Abweichungen steckte
Drei Muster erklären fast alles.
Das dritte Muster ist das interessanteste, weil es keine Fehlerquelle ist. Es ist eine Entscheidung. Für mein Geschäft zählt eine Nachricht wie diese als falscher Ansprechpartner, denn im selben Haus sitzt weiterhin jemand, der zuständig ist. Wer sie als Absage bucht, wirft ein Unternehmen weg, das noch offen ist.
| Muster | Beispiel aus den Daten | Warum es schiefgeht |
|---|---|---|
| Höflichkeit gelesen als Interesse | Ich bin ab dem 7. April wieder im Büro, geführt als positiv | Die automatische Einordnung bewertet den Ton, nicht die Aussage |
| Absage gelesen als falscher Ansprechpartner | Danke, aber wir haben keinen Bedarf | Wer die Kategorien nicht trennt, verschiebt nur Müll von einem Topf in den anderen |
| Zwei Dinge in einer Nachricht | Herr X arbeitet nicht mehr hier, bitte keine Mails mehr | Das ist Absage und falscher Ansprechpartner zugleich. Ein Topf kann das nicht abbilden |
Bessere Fragen haben nichts gebracht
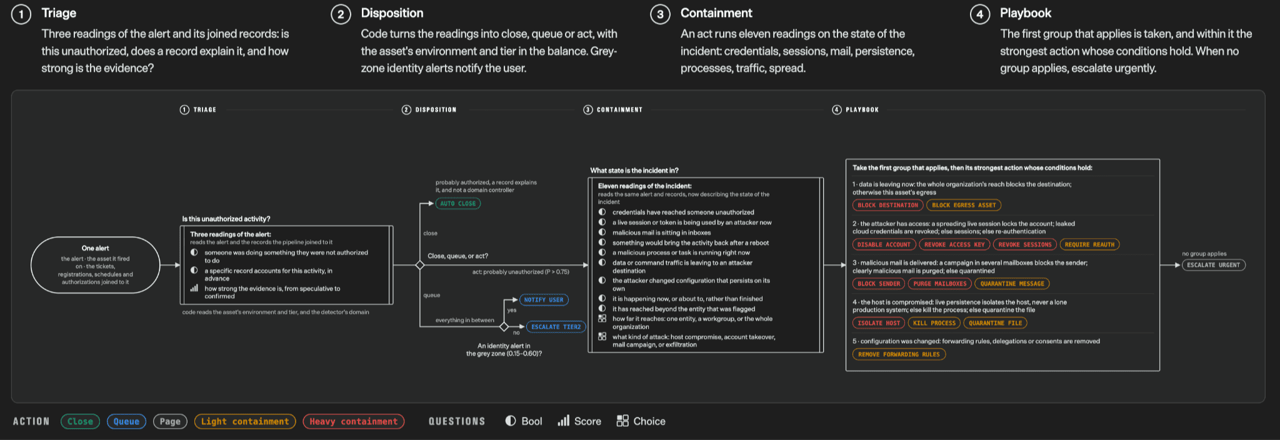
Nachdem die erste Fassung bei 89 Prozent lag, habe ich die Fragen dreimal nachgeschärft: einmal mit einer ausformulierten Rangfolge, einmal mit vielen Einzelfragen und einer Regel im Programmcode, einmal mit einer gezielten Ergänzung.
Die Deckelung liegt nicht bei der Formulierung. Sie liegt bei den Etiketten, an denen gemessen wird. Ungefähr jede zwanzigste Antwort ist falsch beschriftet, jede zwölfte ist echt doppeldeutig. Über diese Grenze kommt keine Frage hinaus, egal wie gut sie gestellt ist.
Ein Nebenbefund, der mich Zeit gekostet hat: Die Variante mit den Einzelfragen war die aufwendigste und die schlechteste. Ich hatte die Sicherheit selbst aus mehreren Werten zusammengerechnet. Damit war sie wertlos, und die Hälfte der Fälle ging unnötig an einen Menschen. Eine Sicherheitsangabe muss aus einem Urteil kommen, nicht aus einer Bastelei darüber.
| Fassung der Frage | Übereinstimmung | Sicher entschieden |
|---|---|---|
| Schlicht, vier Kategorien | 89 % | 88 % |
| Rangfolge in der Anweisung | 88 % | 86 % |
| Einzelfragen plus Regel im Code | 85 % | 53 % |
| Schlicht plus eine Ergänzung | 89 % | 91 % |
 Vollansicht
Der ChatGPT-Budget-Killer: warum Sortieren kein Job für Chatmodelle ist
Die naheliegende Frage lautet: Kann das nicht einfach ChatGPT? Sortieren kann es auch. Für eine Maschine, die ohne Aufsicht läuft, fehlen ihm aber zwei Dinge.
Erstens liefert ein Chatmodell Text. Es schreibt dir: Das klingt nach einer Abwesenheitsnotiz, vermutlich kein Interesse. Damit kann ein Mensch etwas anfangen, eine Software nicht. Ein Arbeitsablauf braucht einen von vier festen Werten, jedes Mal exakt gleich geschrieben.
Zweitens sagt ein Chatmodell nicht ehrlich, wie sicher es ist. Es formuliert höflich weiter, auch wenn die Lage unklar ist. Genau diese Angabe brauchst du aber, um zu entscheiden, was ohne Nachprüfen durchlaufen darf.
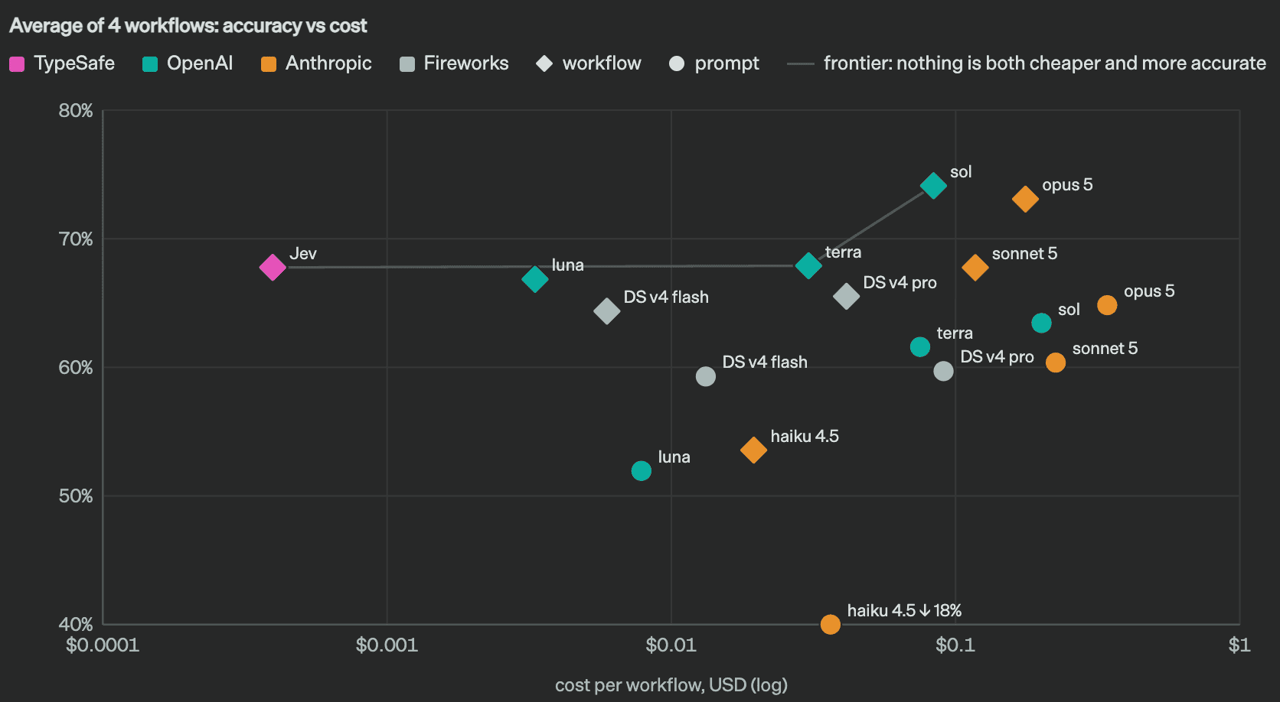
Drittens der Preis, und hier kommt der Spitzname her. Ein Chatmodell rechnet jedes Wort ab, das es liest, und jedes, das es schreibt, die geschriebenen meist fünfmal teurer. Jev rechnet nur ab, was es liest: laut Hersteller 0,042 Dollar je Million Token (Textbausteine, grob drei Viertel eines Worts). Die Ausgabe kostet nichts. In meinem Test waren das 0,6 Cent für 193 Antworten, also rund 3 Cent für 1.000. Ein Chatmodell der oberen Klasse liegt bei derselben Textmenge bei rund 3 Dollar. Für Sortierarbeit ist ein Chatmodell ein Budgetfresser.
Das Bild, das es trifft: Ein Chatmodell ist der Kollege, der dir eine Einschätzung aufschreibt. Ein Entscheidungsmodell ist der Mitarbeiter an der Poststelle, der jeden Brief in eines von vier Fächern legt und dazusagt, bei welchen er sich nicht sicher war. Beides hat seinen Platz. Die Antwort an den Kunden schreibt weiterhin ein Mensch. Die Frage, in welches Fach etwas gehört, gehört an die Stelle, die schnell, billig und ehrlich unsicher ist.
| Chatmodell (ChatGPT, Claude) | Jev (Entscheidungsmodell) | |
|---|---|---|
| Ergebnis | Text zum Lesen | ein Wert aus einer Liste, die du vorgibst |
| Angabe zur Sicherheit | keine belastbare | Zahl zwischen 0 und 1, geeicht |
| Tempo je Antwort | mehrere Sekunden | 0,8 Sekunden, aus Deutschland gemessen |
| Preis je Million gelesener Token | 0,20 bis 10 Dollar | 0,042 Dollar |
| Preis für die Ausgabe | etwa fünfmal teurer als die Eingabe | kostenlos |
| Kosten für 1.000 Antworten | rund 3 Dollar, gerechnet | rund 3 Cent, gemessen |
| Kann es etwas erfinden? | ja, auch neue Kategorien | nein, nur erlaubte Werte. Falsch liegen kann es trotzdem |
| Wofür es gemacht ist | schreiben, zusammenfassen, beraten | einsortieren, weiterleiten, freigeben |
 Vollansicht
Die Schwelle ist das eigentliche Werkzeug
Interessant ist nicht die Gesamtquote. Interessant ist, wie viel ohne Nachprüfen laufen darf.
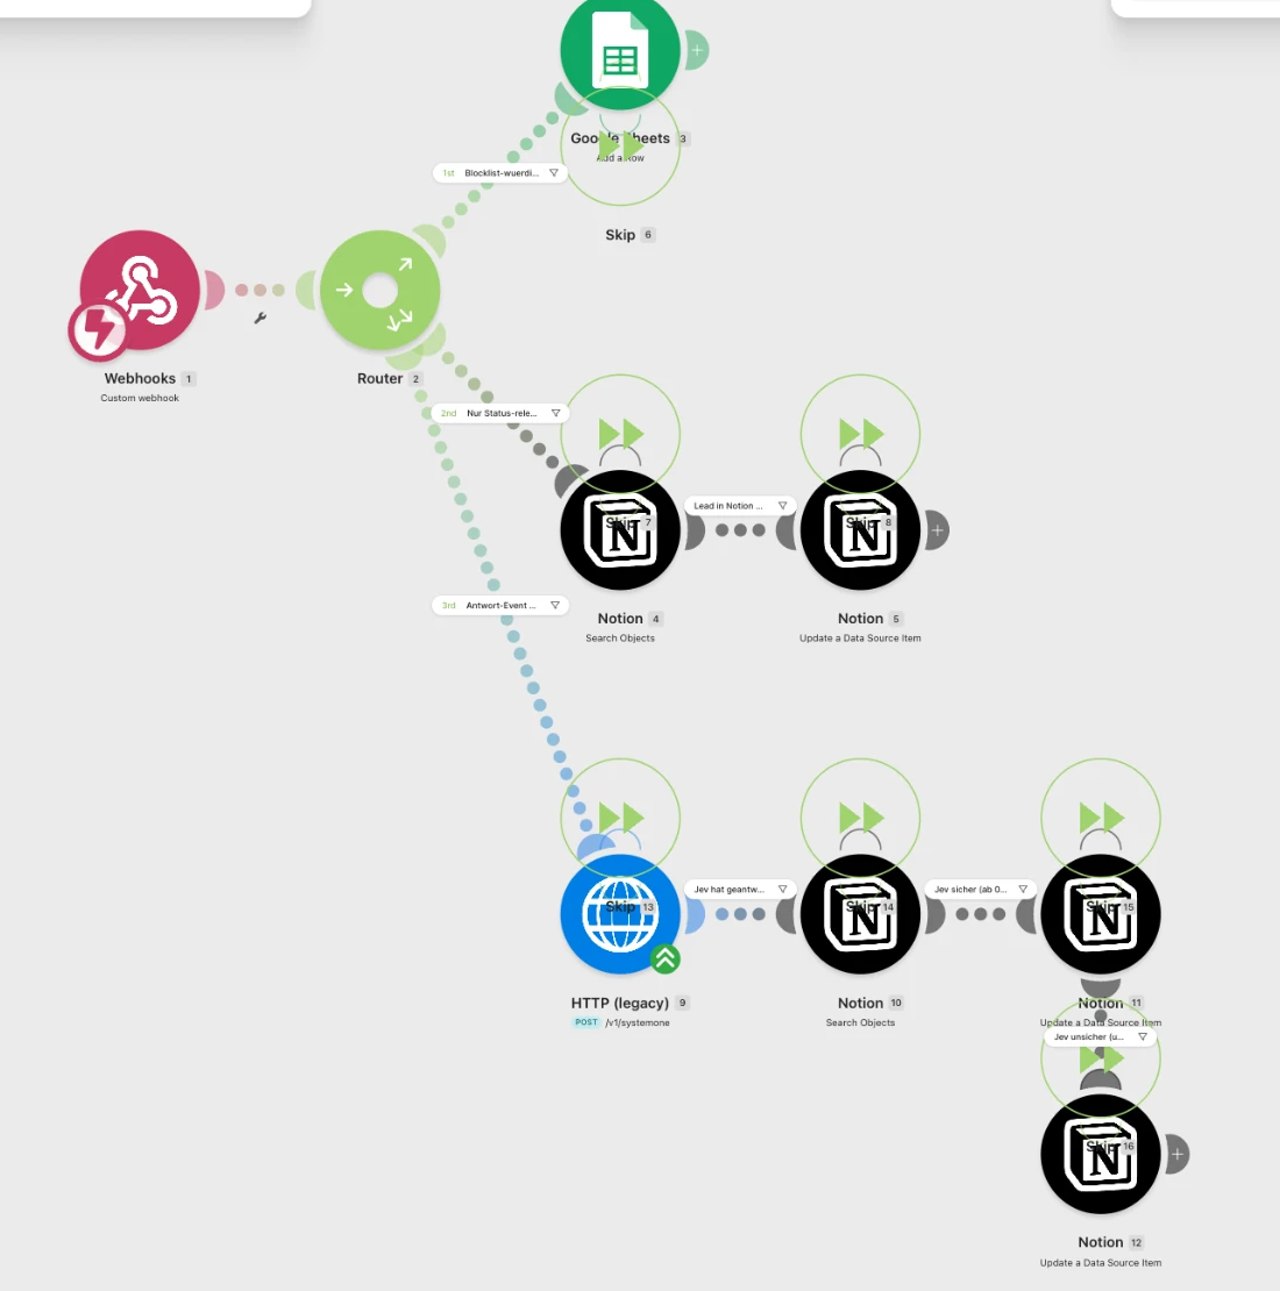
Genau so läuft es jetzt bei mir: Jede eingehende Antwort wird eingeordnet, sichere Fälle landen direkt in der Datenbank, unsichere bekommen den Status Prüfen und eine eigene Ansicht. Die Arbeit schrumpft von alle Antworten lesen auf neun von hundert lesen.
Der Aufbau dahinter ist unspektakulär: Das Versandtool meldet eine eingegangene Antwort, der Text geht an das Modell, das Urteil samt Sicherheit läuft zurück in die Datenbank. Drei Arbeitsschritte je Antwort, keine Handarbeit.
| Sicherheit des Urteils | Anteil der Antworten | Was passiert |
|---|---|---|
| ab 0,9 | 91 % | wird automatisch einsortiert |
| unter 0,9 | 9 % | bekommt den Status Prüfen und geht an einen Menschen |
 Vollansicht
So sparst du Credits: sechs Stellschrauben
Credits kosten an zwei Stellen: beim Modell selbst und im Automatisierungswerkzeug, das jeden Arbeitsschritt zählt. Bei mir sind es drei Schritte je Antwort.
Die größte Ersparnis liegt nicht im günstigsten Tarif. Sie liegt in der Arbeitsteilung: Welche Aufgabe braucht wirklich ein Modell, das schreiben kann? Einsortieren, weiterleiten, freigeben braucht es nicht. Alles, was unten in der Tabelle steht, habe ich in meinem eigenen Ablauf umgesetzt oder beim Nachschärfen teuer gelernt.
| Stellschraube | Was du tust | Was es spart |
|---|---|---|
| Richtiges Modell für den Job | Einsortieren an Jev, nur das Schreiben an ein Chatmodell | Rund Faktor 100 bei den Modellkosten |
| Filter vor dem Aufruf | Nur echte Antworten mit Text weiterleiten, leere Meldungen und Versandereignisse vorher aussortieren | Ein Filter kostet keinen Arbeitsschritt, ein Aufruf kostet einen |
| Alle Fragen in einen Aufruf | Kategorie und Zusatzfragen gemeinsam stellen | Der Text wird nur einmal gelesen und bezahlt, die Antworten kosten nichts |
| Nur die Antwort senden | Zitierten Mailverlauf und Signatur abschneiden | Bezahlt wird nur gelesener Text, und der Verlauf ist oft länger als die Antwort |
| Schwelle statt Vollkontrolle | Ab 0,9 Sicherheit automatisch, darunter Status Prüfen | Ein Mensch liest 9 statt 100 von 100 Antworten |
| Sicherheit nicht selbst basteln | Die Sicherheit aus dem Urteil übernehmen, nicht aus Einzelwerten zusammenrechnen | Meine Bastelvariante schickte 47 statt 9 von 100 Antworten an einen Menschen |
Was das für deinen Vertrieb bedeutet
Das Thema ist nicht Kaltakquise. Das Thema ist die Kette, an deren Ende eine Steuerungszahl steht.
Deine Quoten sind so gut wie die Etiketten darunter. Bevor du eine Kampagne abschaltest oder ausbaust, prüfe zwanzig Antworten von Hand nach. Das dauert zwanzig Minuten und beantwortet, ob deine Zahl trägt.
Ferienzeiten verzerren stärker, als man denkt. Abwesenheitsnotizen machen in meinem Bestand den größten Einzelblock aus. Wer sie nicht herausrechnet, misst im Sommer eine gesunde Kampagne, die keine ist.
Derselbe Fehler steckt in jedem CRM. Gewonnen, verloren, kein Interesse: Das sind ebenfalls Etiketten, die jemand nebenbei setzt. Jede Auswertung darüber erbt ihre Fehler.
Was dieser Artikel nicht beweist
Die 193 Antworten stammen aus einem Postfach und aus meinen eigenen Kampagnen. Andere Zielgruppen antworten anders.
Ob ein Etikett falsch war, habe ich selbst beurteilt. Bei den klaren Fällen ist das unstrittig, eine Urlaubsnotiz ist keine Zusage. Bei den acht doppeldeutigen Fällen ist es eine Entscheidung, keine Wahrheit.
Die Aussage, dass jede zehnte positive Antwort keine war, stammt aus 50 geprüften positiven Antworten. Sie ist ein Befund, keine belastbare Quote.
Getestet ist die Einordnung, nicht die Frage, ob dadurch mehr Termine entstehen. Diese Zahl liegt erst nach einigen Wochen Betrieb vor, und sie kommt in eine zweite Fassung dieses Artikels.
Die Vergleichszahlen zu anderen Modellen stammen von TypeSafe selbst. Der Hersteller schreibt offen, dass seine Werte von 193-mal schneller und 444-mal billiger eher am oberen Ende realer Einsätze liegen. Nachgemessen habe ich nur Tempo und Kosten von Jev, nicht die der Chatmodelle. Deren Kosten oben sind eine Rechnung mit derselben Textmenge.
Häufige Fragen
Jev ist ein KI-Modell von TypeSafe AI, erschienen am 15. September 2026. Es schreibt keinen Text. Du gibst die erlaubten Antworten vor, Jev wählt eine davon und nennt zu jeder eine Wahrscheinlichkeit. Gemacht ist es für Einsortieren, Weiterleiten und Freigeben in automatischen Abläufen.
Laut Hersteller 0,042 Dollar je Million gelesener Token, die Ausgabe ist kostenlos. In meinem Test kosteten 193 Einordnungen zusammen 0,6 Cent, hochgerechnet rund 3 Cent für 1.000 Antworten. Ein Chatmodell der oberen Klasse liegt bei derselben Textmenge bei rund 3 Dollar.
Zieh zwanzig Antworten aus deinem Versandtool oder CRM, verdecke das vergebene Etikett und ordne sie selbst ein. Danach vergleichst du. Stimmen mehr als ein oder zwei nicht, ist deine Quote als Steuerungsgröße unbrauchbar. Der Test dauert zwanzig Minuten und braucht keine Software.
Das Modell gibt zu jedem Urteil an, wie eindeutig die Lage für es war, als Zahl zwischen 0 und 1. Hohe Sicherheit heißt, die Antwort passt klar in eine Kategorie. Niedrige Sicherheit heißt, es hätte auch etwas anderes sein können. Erst diese Angabe macht eine Schwelle möglich, ab der ohne Mensch entschieden wird.
Weil ein Chatmodell Text liefert und keine belastbare Angabe zu seiner Sicherheit. Für eine Auswertung reicht das, für einen Ablauf, der ohne Aufsicht läuft, nicht. Dazu kommen Tempo und Preis: Jev brauchte 0,8 Sekunden je Antwort und rund 3 Cent für 1.000 Antworten, ein Chatmodell braucht mehrere Sekunden und rund 3 Dollar.
Bei zehn Antworten im Monat nicht. Der Aufwand liegt im Aufbau, nicht im Betrieb. Ab etwa fünfzig Antworten im Monat spart es spürbar Zeit, und ab da wird die Quote als Steuerungsgröße überhaupt erst brauchbar.
Weil sie in meinem Bestand den größten Einzelblock ausmachen und weil sie freundlich klingen. Eine automatische Einordnung bewertet den Ton. In der Ferienzeit kann eine Kampagne dadurch gesund aussehen, obwohl kein einziges Gespräch näher gerückt ist. Deshalb gehören sie vor jeder Auswertung heraus.
Ja. In 193 geprüften Antworten lag sie einmal klar daneben, und dieser Fall hatte eine niedrige Sicherheit und wäre im Betrieb zur Prüfung gegangen. Der Unterschied zum Etikett aus dem Versandtool ist nicht Unfehlbarkeit. Es ist die ehrliche Angabe, wann es knapp war.
Du weißt nicht, welche Firmen gerade Bedarf haben?
Saubere Zahlen helfen nur, wenn die richtigen Firmen in der Liste stehen. Ich stelle dir eine Liste mit Unternehmen zusammen, bei denen gerade ein Anlass sichtbar ist, mit Ansprechpartner und Grund.
Drei Listen pro Woche, mehr schaffe ich nicht. Wenn dein Markt zu klein ist, sage ich das im ersten Gespräch.